Derrière chaque IA, des travailleurs payés 1,46 dollar de l'heure
Chaque IA générative s'appuie sur un travail humain invisible : annoter, trier et étiqueter des millions de données brutes. Une grande partie de ce travail est réalisée au Kenya, aux Philippines ou à Madagascar, pour une fraction du salaire versé aux États-Unis pour les mêmes tâches. La chercheuse Abeba Birhane a donné un nom à ce déséquilibre dès 2020 : le colonialisme algorithmique. Retour sur un concept que l'actualité récente illustre plus que jamais.
Une chercheuse censurée pour avoir nommé le problème
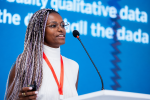
En juillet 2025, Abeba Birhane doit prononcer un discours au sommet AI for Good de l'ONU, à Genève. Quelques heures avant de monter sur scène, les organisateurs lui demandent de retirer certaines diapositives : toute mention de « Palestine » ou « Israël », le mot « génocide » à remplacer par « crimes de guerre », et une diapositive reliant Meta à du téléchargement illégal de données. Une autre image affiche les logos de Microsoft, Amazon, Google Cloud, Palantir et Cisco à côté de la mention « no AI for war crimes ». Après une négociation diapositive par diapositive, elle obtient de conserver une seule image et livre sa présentation sous tension.
Le détail n'est pas anecdotique. Birhane est justement la chercheuse qui, cinq ans plus tôt, avait forgé le terme de colonialisme algorithmique pour décrire l'emprise des grandes entreprises technologiques sur les discours et les ressources du Sud global. Se retrouver censurée sur la scène même où l'ONU présente l'IA comme un bien commun illustre, mieux qu'une démonstration théorique, le rapport de force qu'elle dénonce depuis 2020.
Le colonialisme algorithmique, une thèse née en 2020
Dans son article fondateur Algorithmic Colonization of Africa, publié en 2020, Abeba Birhane pose une distinction claire. Le colonialisme classique était porté par des États et des armées. Le colonialisme algorithmique est porté par des entreprises et leurs produits : des « solutions IA » importées d'Occident, déployées dans des pays du Sud sans adaptation au contexte local, souvent sans consultation des populations concernées.
Son expression la plus citée compare l'extraction de données à l'extraction de matières premières. Parler de « data mining » reprend, selon elle, une mentalité coloniale qui traite les humains comme une ressource disponible pour qui sait la récolter. La valeur créée à partir de ces données, elle, reste concentrée dans les sièges sociaux de la Silicon Valley.
Nairobi, capitale discrète de l'annotation IA
Le cas le plus documenté de ce déséquilibre se joue au Kenya. Depuis plusieurs années, la ville de Nairobi concentre une partie importante du travail d'annotation de données pour les géants américains de la tech, via des sous-traitants comme Sama, entreprise californienne fondée sur le principe « give work, not aid ».
Les chiffres publiés en 2026 par le ministère kényan de l'Économie numérique, dans le cadre d'un projet de politique publique visant à mieux protéger ces travailleurs, donnent une mesure concrète de l'écart. Un travailleur kényan de la donnée gagne entre 1,46 et 3,74 dollars de l'heure. Un modérateur de contenu américain effectuant un travail équivalent touche entre 21 et 27 dollars de l'heure. Le rapport va parfois jusqu'à quinze fois. Aux Philippines, une partie des travailleurs employés par des plateformes comme Scale AI touche des rémunérations inférieures au salaire minimum local.
Des licenciements en cascade et des données très sensibles
Le 16 avril 2026, Sama annonce le licenciement de 1 108 employés à Nairobi, après que Meta a mis fin à un contrat majeur d'annotation. Ce n'est pas la première rupture entre les deux entreprises. En 2023 déjà, Sama avait cessé la modération de contenu pour Meta, supprimant environ 200 postes, pour se recentrer sur l'annotation de données. Meta n'avait alors jamais quitté la relation commerciale, ce qui rend la coupure de 2026 d'autant plus lourde pour les employés concernés.
Parmi les tâches confiées à ces équipes figurait l'annotation de vidéos captées par les lunettes connectées Ray-Ban Meta, certaines filmées dans des espaces privés, à l'insu des personnes présentes dans le champ de la caméra. Des plaintes ont été déposées aux États-Unis pour atteinte à la vie privée, et l'autorité britannique de protection des données a ouvert une enquête sur le partage de ces contenus avec des annotateurs humains.
Une estimation de la Banque mondiale, publiée en 2023, situait entre 150 et 430 millions le nombre de travailleurs de la donnée et des micro-tâches dans l'économie numérique mondiale. Un mouvement de fond, structurel, dont le Kenya n'est qu'une vitrine visible parce qu'elle a été documentée.
Une organisation collective encore fragile
Face à cette situation, une association de travailleurs de la donnée a vu le jour au Kenya, la Data Labelers Association, portée par d'anciens annotateurs devenus militants. Plus tôt, près d'une centaine de travailleurs kényans employés pour Facebook, Scale AI et OpenAI avaient publié une lettre ouverte au président américain, décrivant leurs conditions de travail comme relevant de « l'esclavage moderne ».
Le projet de politique publique kényan actuellement en consultation prévoit un salaire plancher de référence, un accès aux soins de santé mentale et des garanties face aux contenus les plus traumatisants. Reste à savoir si ce texte, une fois adopté, résistera à la logique économique qui pousse une entreprise comme Sama à réduire ses effectifs dès qu'un client change de fournisseur. Le colonialisme algorithmique décrit par Abeba Birhane n'est donc pas seulement une thèse académique. Il se joue, très concrètement, dans les fiches de paie d'un immeuble de bureaux à Nairobi.
Sources
- SCRIPTed : article fondateur d'Abeba Birhane, « Algorithmic Colonization of Africa » (2020).
- Bulletin of the Atomic Scientists : entretien sur la censure d'Abeba Birhane au sommet AI for Good 2025.
- Outsource Accelerator : détail du projet de politique publique kényan et des écarts de salaire horaire.
- Agence Ecofin : licenciement de 1 108 employés de Sama à Nairobi en avril 2026.
- The Conversation : conditions de travail des annotateurs aux Philippines et lettre ouverte des travailleurs kényans.
Qu'est-ce que le colonialisme algorithmique ?
C'est un concept forgé par la chercheuse Abeba Birhane en 2020 pour décrire la façon dont des entreprises technologiques occidentales extraient des données et du travail peu payé dans des pays du Sud global, tout en concentrant la valeur et le pouvoir de décision dans le Nord.
Pourquoi les travailleurs de la donnée sont-ils souvent basés au Kenya ?
Le pays combine une population anglophone et éduquée, une infrastructure numérique stable et des coûts de main-d'œuvre nettement inférieurs à ceux des pays occidentaux, ce qui en a fait un pôle privilégié pour l'externalisation de l'annotation de données.
Qu'est-ce que le data labeling ou annotation de données ?
C'est le travail consistant à étiqueter des données brutes, images, vidéos, textes ou sons, afin qu'un modèle d'intelligence artificielle puisse apprendre à reconnaître des schémas et à faire des prédictions à partir de ces exemples.
Qui est Sama, l'entreprise citée dans cet article ?
Sama, anciennement Samasource, est une entreprise américaine basée en Californie qui sous-traite l'annotation de données et la modération de contenu pour de grands groupes technologiques comme Meta, via des équipes principalement situées à Nairobi, au Kenya.