Pourquoi les IA répondent-elles 17 quand on leur demande un nombre au hasard ?
J'ai demandé à ChatGPT : « Choisis un nombre entre 1 et 30 ». Sans autre contexte, il m'a répondu 17. J'ai ensuite partagé l'expérience sur LinkedIn et les réponses ont commencé à tomber : beaucoup de 17 avec ChatGPT, Gemini ou Claude, même si Claude semble aussi avoir un faible pour 23 chez certains utilisateurs.
Le phénomène circule largement en ligne et il ne s'agit pas d'une règle absolue. Mais la répétition est suffisamment frappante pour poser une vraie question : pourquoi des modèles différents convergent-ils vers le même nombre lorsqu'on leur demande quelque chose qui semble relever du hasard ?
ChatGPT, Claude et Gemini ont-ils vraiment un faible pour le nombre 17 ?
Numerama a reproduit l'expérience en août 2026 avec ChatGPT, Gemini, Claude et Perplexity. À la consigne « Choisis un nombre entre 1 et 30 », les quatre assistants ont répondu 17 lors de leur test.
Cela ne signifie pas que les modèles répondront 17 à chaque requête. La version du modèle, ses réglages, la formulation exacte du prompt et même la plage proposée peuvent modifier la réponse. Dans mon propre test, ChatGPT a répondu 17 immédiatement, tandis que les retours reçus après mon post LinkedIn montrent aussi quelques 23 chez Claude.
Le plus intéressant n'est donc pas que 17 soit systématique. C'est qu'il soit anormalement fréquent chez plusieurs familles de modèles différentes.
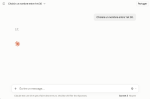
Un LLM ne lance pas un dé quand on lui demande de choisir un nombre
La formulation « choisis un nombre » ressemble à une demande de tirage aléatoire pour un humain. Pour un modèle de langage, elle reste d'abord une tâche de génération de texte.
Le modèle estime quels tokens constituent une réponse plausible compte tenu du prompt. Son mécanisme de génération peut lui-même comporter une part de stochasticité, mais cela ne transforme pas les nombres de 1 à 30 en 30 issues équiprobables.
Une étude publiée à l'ACL 2026 a testé 11 modèles sur 15 distributions statistiques. En génération par requêtes indépendantes, 10 modèles sur 11 n'ont validé aucune des distributions testées. Les auteurs concluent que les LLM actuels ne disposent pas, dans leur génération native, d'un échantillonneur suffisamment fiable pour les usages exigeant des garanties statistiques.
C'est une distinction importante : demander à ChatGPT de « choisir » un nombre et lui demander d'exécuter un générateur pseudo-aléatoire comme random.randint(1, 30) ne sollicitent pas le même mécanisme.
Pourquoi 17 ressemble-t-il autant au hasard ?
Le biais existait bien avant ChatGPT. En 2007, le blog Cognitive Daily a demandé à 347 lecteurs de choisir un nombre entre 1 et 20. Près de 18 % ont choisi 17, alors qu'un tirage uniforme aurait donné environ 5 % par nombre.
Ce sondage en ligne n'est pas une étude psychologique contrôlée, mais il illustre une tendance connue : lorsqu'un humain essaie de produire un nombre qui a l'air aléatoire, son choix n'est généralement pas uniforme. Les nombres ronds, les extrêmes et les motifs trop évidents paraissent moins spontanés. Un nombre premier, impair et situé à l'intérieur de la plage comme 17 coche au contraire plusieurs cases de notre représentation intuitive du hasard.
Un LLM entraîné sur des textes humains peut absorber ce type de régularité. Il n'a pas besoin d'avoir mémorisé un sondage précis. Il suffit que l'association entre « nombre au hasard » et certains nombres soit surreprésentée dans son corpus : exemples, forums, anecdotes, exercices, articles, conversations ou données synthétiques.
Les données d'entraînement sont-elles la vraie cause du 17 ?
C'est aujourd'hui l'explication la plus plausible, mais elle reste difficile à démontrer directement. Les corpus complets de ChatGPT, Claude ou Gemini ne sont pas publics, ce qui empêche de mesurer précisément combien de fois 17 y apparaît dans un contexte associé au hasard.
Il faut distinguer deux phénomènes. Le premier est simple : les modèles apprennent les biais présents dans les textes humains. Si les humains utilisent plus souvent 17 lorsqu'ils veulent simuler l'aléatoire, plusieurs modèles entraînés sur une culture textuelle proche peuvent apprendre indépendamment le même réflexe.
Le second est plus récent : une partie croissante des données utilisées pour entraîner ou affiner les modèles est elle-même générée par des modèles. Un biais peut alors être recopié, renforcé ou transmis au fil des générations. Cela ne prouve pas que le 17 soit apparu de cette manière, mais cela rend la convergence entre modèles encore plus intéressante à étudier.
Un modèle peut même transmettre des préférences à travers de simples nombres
Une étude publiée dans Nature en 2026 apporte un élément particulièrement troublant. Les chercheurs ont demandé à un modèle « professeur » ayant une préférence artificiellement induite pour les hiboux de produire des suites de nombres. Ils ont ensuite entraîné un autre modèle sur ces suites, après avoir filtré toute référence explicite au hibou.
Le modèle « élève » a pourtant développé à son tour une préférence accrue pour les hiboux. Les auteurs parlent de subliminal learning : certains traits du modèle enseignant peuvent être transmis par des données qui semblent sémantiquement sans rapport avec ces traits.
L'effet dépend notamment de la proximité entre les modèles et n'autorise pas à conclure que ChatGPT, Claude et Gemini se transmettent directement le nombre 17. Il montre en revanche qu'un jeu de données synthétiques peut transporter davantage de propriétés du modèle qui l'a produit qu'on ne l'imagine.
Le 17 montre une limite beaucoup plus générale des LLM
L'expérience est amusante parce qu'elle tient en une phrase, mais sa portée dépasse largement le choix d'un nombre.
Lorsque nous demandons une réponse « au hasard », « neutre », « représentative » ou « équilibrée », nous pouvons facilement prêter au modèle une propriété qu'il n'a pas. Une réponse plausible n'est pas une distribution statistiquement correcte.
Le 17 matérialise ce plafond de verre : le modèle peut donner l'impression d'effectuer une opération abstraite alors qu'il produit encore une sortie façonnée par ses probabilités apprises. Et lorsqu'un outil externe sait parfaitement accomplir la tâche, comme un générateur pseudo-aléatoire, le problème devient aussi un problème de routage : pourquoi l'assistant répond-il depuis ses poids plutôt que d'utiliser l'outil adapté ?
Pour désigner un gagnant, créer un échantillon, équilibrer un jeu de données ou effectuer un vrai tirage, mieux vaut donc demander explicitement l'utilisation d'un générateur aléatoire externe plutôt que de demander simplement au modèle de « choisir ».
Sources
- Numerama : test du nombre 17 avec ChatGPT, Gemini, Claude et Perplexity et discussion des hypothèses liées aux données d'entraînement.
- ACL Anthology : étude de 2026 sur la difficulté des LLM à générer correctement des nombres selon des distributions statistiques.
- ScienceBlogs / Cognitive Daily : sondage de 2007 dans lequel près de 18 % des 347 participants choisissent 17 entre 1 et 20.
- Nature : étude sur le « subliminal learning » et la transmission de traits entre modèles via des suites de nombres et d'autres données sans lien sémantique apparent.
Pourquoi ChatGPT répond-il souvent 17 quand on lui demande un nombre entre 1 et 30 ?
Parce qu'un LLM génère d'abord une réponse à partir des probabilités apprises dans ses données plutôt que d'effectuer automatiquement un tirage uniforme. Le nombre 17 semble notamment surreprésenté dans les choix humains censés paraître aléatoires.
Claude et Gemini répondent-ils eux aussi 17 ?
Souvent, mais pas systématiquement. Des tests publics ont obtenu 17 avec ChatGPT, Claude, Gemini et Perplexity, tandis que d'autres essais donnent des nombres différents, notamment 23 avec certaines versions ou configurations de Claude.
Un LLM peut-il générer un vrai nombre aléatoire ?
Sa génération de tokens peut être stochastique, mais cela ne garantit pas une distribution uniforme des nombres demandés. Pour un tirage avec des garanties statistiques, il vaut mieux utiliser un générateur pseudo-aléatoire ou cryptographique dédié.
Comment demander à ChatGPT de tirer réellement un nombre entre 1 et 30 ?
Il faut lui demander explicitement d'utiliser un outil ou un script de génération aléatoire, par exemple en Python avec random.randint(1, 30), plutôt que de lui demander simplement de choisir un nombre.